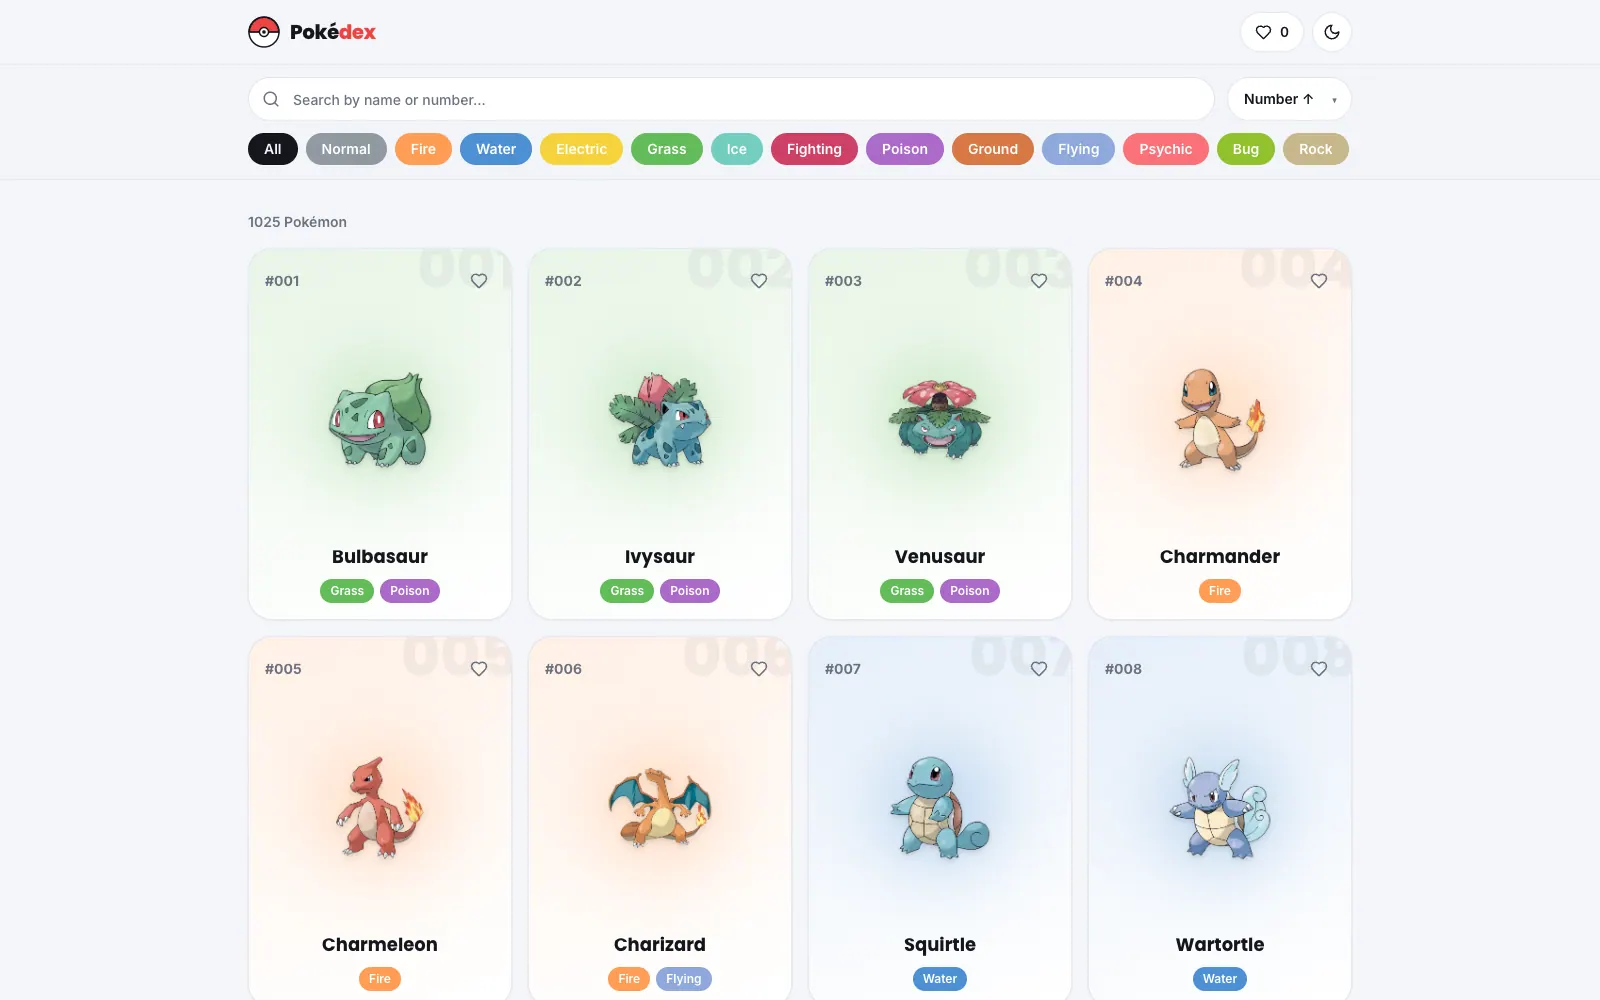
Чому це тут, якщо тема — гра
Тема тут ні до чого. Важить конструкція: сайт, який не має власних даних і мусить їх показувати — із сервісу, що йому не підпорядкований.
Це звичайна комерційна ситуація. Магазин тягне ціни й залишки зі складської системи. Студія — розклад із сервісу записів. Служба доставки — статуси посилок. І всі впираються в ті самі чотири питання, а PokéAPI просто дає відповісти на них публічно й безкоштовно:
- Що показувати, поки дані ще в дорозі?
- Що показувати, коли запит не вдався?
- Як не питати одне й те саме по пʼять разів?
- Як шукати й фільтрувати понад тисячу позицій без паузи після кожної літери?
Індекс завантажується раз і більше ніколи
Каталог просить у сервісу повний перелік — назви та номери — рівно один раз і тримає його. Пошук і сортування далі працюють по цьому списку в памʼяті, тож набір тексту фільтрує миттєво, а не шле запит на кожен символ.
З деталями інакше: характеристики, здібності, ланцюг еволюції підтягуються лише тоді, коли картку справді відкрили. Завантажити все наперед означало б понад тисячу запитів на дані, у які більшість відвідувачів ніколи не загляне.
Під усім цим — невеликий кеш. Він зберігає не результат запиту, а сам проміс, і це тихо розвʼязує проблему, помітну лише в реальному житті: коли три компоненти просять одне й те саме в один момент, вони приєднуються до одного запиту, а не запускають три. Якщо запит провалився, запис із кешу зникає — тож повторна спроба справді пробує ще раз, а не відтворює ту саму помилку без кінця.
Кешувати проміс, а не відповідь, — рішення на два рядки, яке прибирає цілий клас зайвого трафіку. На клієнтському проєкті це різниця між комфортним рахунком за API й некомфортним.
Фільтри, які не смикають сервер
Фільтр за типом — єдине, що справді потребує додаткового запиту, бо належності до типу в індексі немає. Тож застосунок один раз забирає список номерів цього типу, тримає його множиною, а далі все зводиться до локального перетину. Повернення до типу, який уже дивилися, не коштує нічого.
Сортування, обране й текстовий пошук взагалі не виходять за межі браузера. Список показує по 24 картки й доростає під час гортання, а пагінація скидається щоразу, коли змінюється фільтр — інакше ви опинилися б на четвертій сторінці списку, у якому тепер дві.
Що бачить відвідувач, поки чекає
Не спінер. Картки зʼявляються сірими каркасами у формі майбутнього вмісту, тож макет уже стоїть на місці й нічого не стрибає, коли дані прийдуть. Якщо сервіс недоступний, застосунок осідає в порожній стан, а не в білий екран: каталог, який не зміг завантажити дані, усе одно має виглядати каталогом.
Дрібниці навколо цього: картка закривається на Esc, сторінка під нею не гортається, поки картка відкрита, а ланцюг еволюції — він приходить вкладеним деревом — розкладається на прості етапи ще до того, як дійде до інтерфейсу.
Компроміси, на які пішов
- Альтернативні форми виключені. Сервіс віддає мега- і ґіґантамакс-варіанти з номерами понад 10 000; вони відфільтровані, щоб каталог збігався з основним переліком, а не показував приховані дублікати.
- Обране лежить на пристрої. Воно в
localStorage, тобто не переїде на інший телефон. Справжні акаунти вимагали б бекенду, а його тут свідомо немає. - Тестів немає. Шар роботи з API відділений від інтерфейсу саме для того, щоб його можна було тестувати, — але самі тести не написані. Краще сказати це, ніж вдавати інше.